Daten und Analytics

Daten und Analytics, eingebaut ins Produkt

Cloudnonic baut die Datenpipelines, Analysen und Berichte, die ein Produkt für die Menschen nützlich machen, die es betreiben: Feldgeräte, die in eine Monitoring-Plattform streamen, Produktkataloge, die eine Optimierungs-Engine speisen, operative Dashboards, die ein Team jeden Morgen öffnet. Wir arbeiten in Python und PostgreSQL auf AWS, im Produkt statt daneben, mit derselben Verantwortung für Korrektheit und Betrieb wie für den Rest der Plattform.

50.000+
Überwachte Produkte
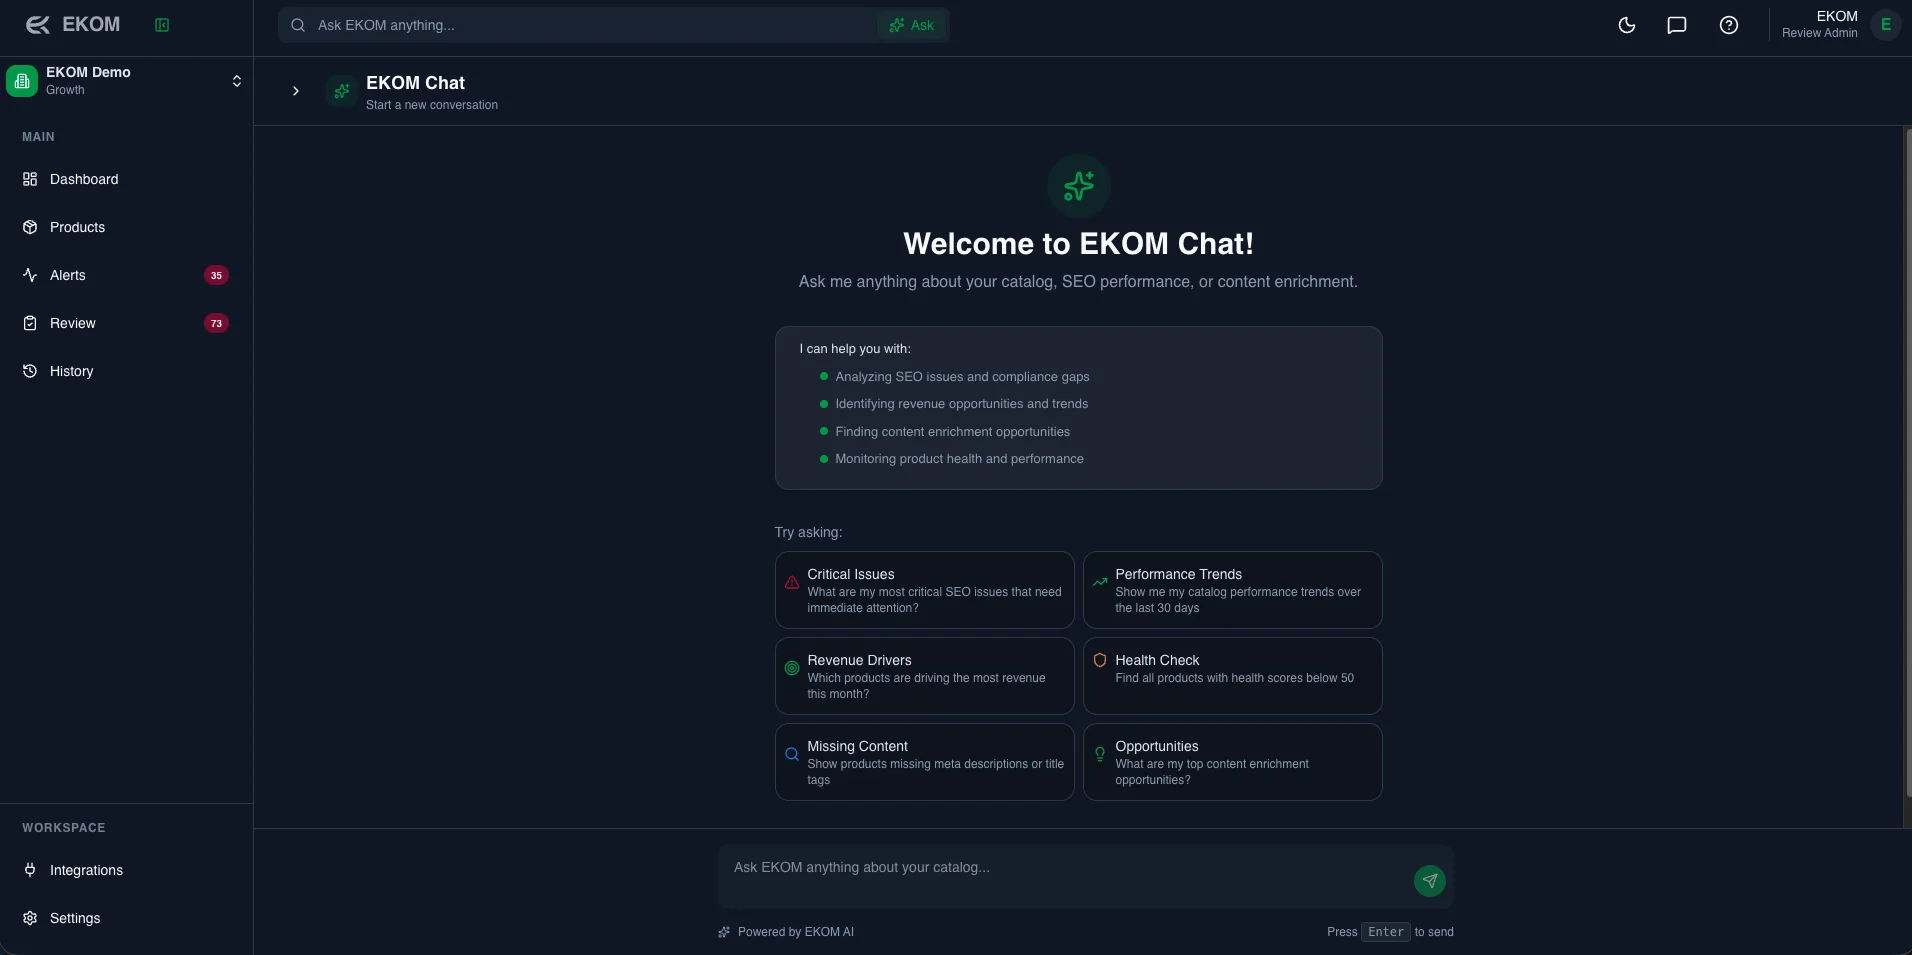
EKOM AI
99,9%
Garantierte Verfügbarkeit
EKOM AI
20+
Teams vertrauen der Plattform
EKOM AI

Was enthalten ist

Datenmodellierung und Ingestion

Schemata für die Ereignisse und Entitäten, die zählen, und Ingestion aus Geräten, APIs und Dateien, die idempotent, validiert und überwacht ist.

Pipelines und Verarbeitung

Batch- und Streaming-Verarbeitung in Python auf AWS, mit Lineage und Reprocessing, damit ein Fehler in einer Transformation korrigiert und erneut ausgeführt werden kann statt geflickt.

Analytics und Dashboards

Kennzahlen, einmal definiert und mit dem Fachbereich abgestimmt, bereitgestellt über Dashboards im Produkt oder in den Werkzeugen, die Ihr Team bereits nutzt.

Alarme und operative Sichten

Schwellen- und Anomalie-Alarme für die Betreiber, mit dem Kontext, den sie zum Handeln brauchen, nicht nur eine Zahl, die eine Linie überschritten hat.

Datenqualität und Betrieb

Tests auf den Daten selbst, Aktualitätsprüfungen, Kostenmonitoring und ein namentlich benannter Entwickler, der die Pipeline in Produktion verantwortet.

Was schiefgeht, und was wir stattdessen entscheiden

  1. Dashboards vor Definitionen

    Diagramme werden aus dem gebaut, was die Datenbank gerade enthält, und zwei Teams lesen verschiedene Zahlen für dieselbe Kennzahl.

    Was es kostet

    Meetings, in denen über Daten gestritten statt entschieden wird, und ein Board-Deck, dem niemand vertraut.

    Wie wir entscheiden

    Jede Kennzahl wird einmal definiert, mit Verantwortlichem und Quelle, bevor ein Diagramm gezeichnet wird.

  2. Pipelines ohne Reprocessing

    Ein Transformationsfehler wird Wochen später gefunden, und es gibt keinen Weg, die Historie neu zu berechnen, also wird der Fehler dokumentiert statt behoben.

    Was es kostet

    Dauerhaft falsche Berichte und manuelle Korrekturen für jede Periode.

    Wie wir entscheiden

    Rohdaten werden aufbewahrt, Transformationen sind versioniert und idempotent, und das Reprocessing einer Periode ist Routine.

  3. Analytics als separates Projekt

    Ein BI-Anbieter baut Berichte neben dem Produkt, mit eigener Datenkopie, und niemand verantwortet die Lücke dazwischen.

    Was es kostet

    Veraltete Zahlen, doppelte Kosten und ein Produkt, das seinen eigenen Nutzern nicht zeigen kann, was passiert.

    Wie wir entscheiden

    Analytics wird vom Team, das das Datenmodell verantwortet, ins Produkt eingebaut, und Reporting-Werkzeuge lesen aus denselben Definitionen.

So arbeiten wir mit Ihnen

So arbeiten wir mit Ihnen

Datenarbeit ist meist Teil eines größeren Plattform-Engagements, weil der Wert im Produkt liegt, das die Daten speisen. Sie kann auch als fester Umfang beginnen: eine Pipeline und ein Satz Dashboards mit einer vereinbarten Definition von richtig, die dann mit dem Produkt wächst.

Ihr Produktteam · Was das verhindert: Einen Prototyp, der nie zur Plattform wird, und eine CTO-Einstellung, bevor das Produkt sie verdient.

Die zwei Zusammenarbeitsmodelle →

Unser Stack

Pro Projekt gewählt. Wir nehmen, was Ihr Team nach uns betreiben kann, nicht was gerade in Mode ist.

  • Python
  • PostgreSQL
  • FastAPI
  • AWS Lambda
  • React
  • React
  • AWS Lambda
  • FastAPI
  • PostgreSQL
  • Python

Belege

Fallstudien in diesem Bereich. Jede Zahl stammt aus der dahinterliegenden Fallstudie.

KI für E-Commerce

EKOM AI

Überwachte Produkte
50.000+
Garantierte Verfügbarkeit
99,9%
Teams vertrauen der Plattform
20+
Support verfügbar
24/7
  • Python
  • React
  • AWS
  • Python
  • React
  • AWS
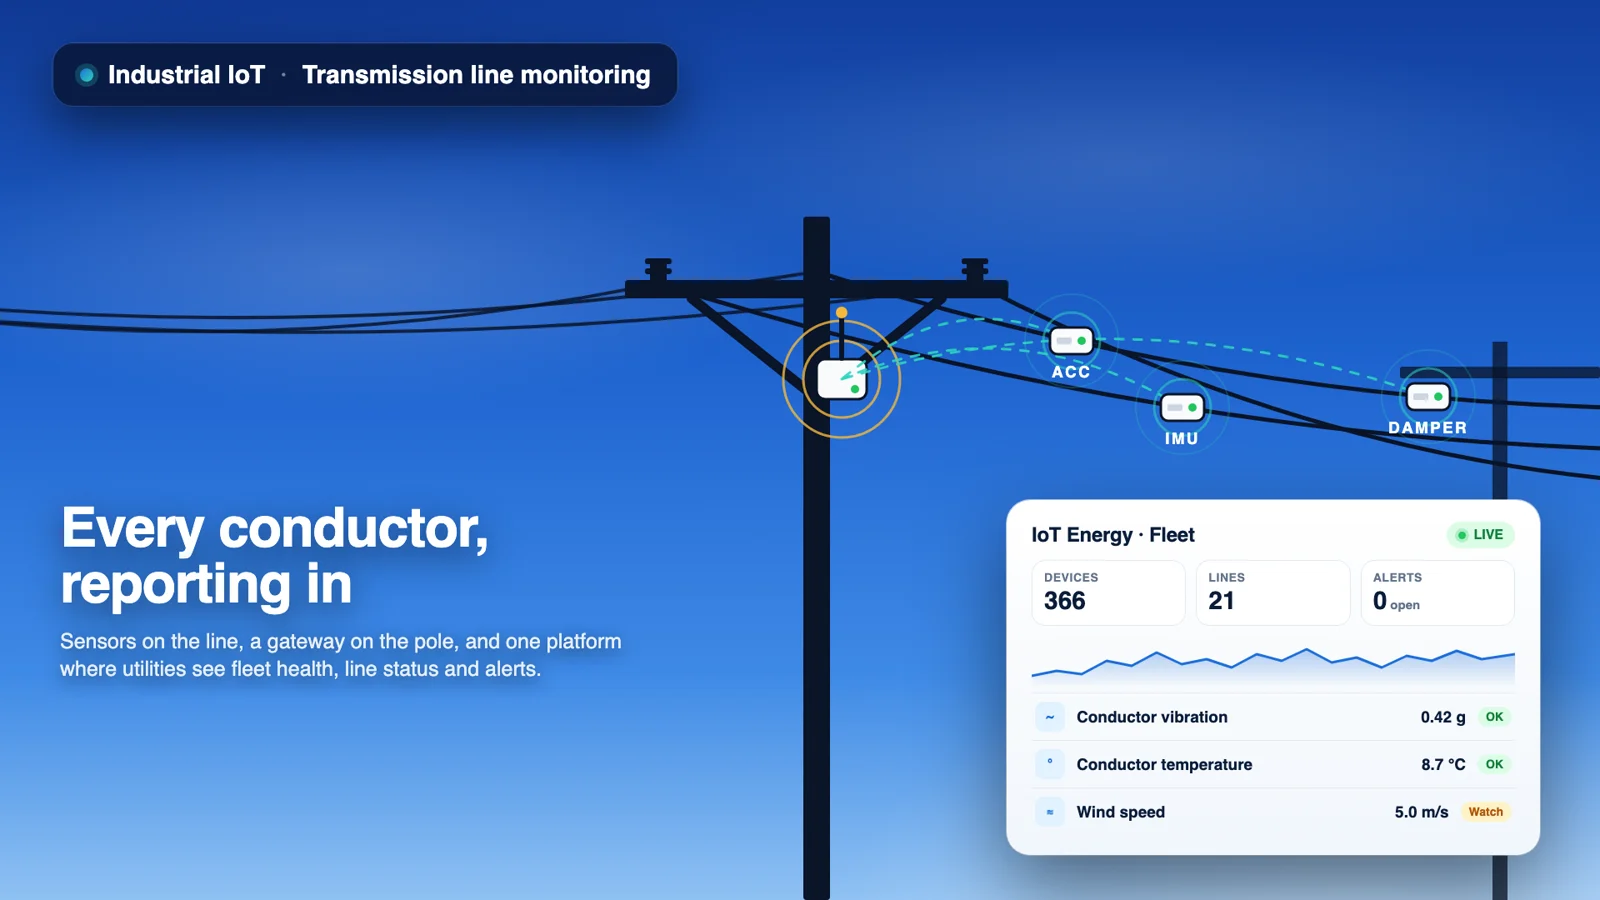
Industrial IoT — Plattform für Netzmonitoring

IoT Energy

Auf der Plattform registrierte Feldgeräte
366+
Überwachte Freileitungen
21+
Netzbetreiber und Partner mit eigenem Mandanten
13+
Sensortypen mit eigener Verarbeitungskette
5+
  • FastAPI
  • React
  • PostgreSQL
  • AWS Lambda
  • Terraform

Häufige Fragen

Bauen Sie Data Warehouses?

Wenn das Produkt eines braucht. Für die meisten Plattformen, die wir betreiben, deckt PostgreSQL mit gut entworfenen Schemata und Python-Verarbeitung auf AWS die analytische Last. Ein Warehouse oder eine Streaming-Schicht führen wir ein, wenn Volumen oder Latenz es verlangen, und wir sagen, welche Zahlen das rechtfertigen.

Können Sie Feldgeräte und Industrieanlagen anbinden?

Ja. Wir haben die Ingestion für Hunderte Feldgeräte mehrerer Gerätetypen in eine einzige Monitoring-Plattform gebaut, mit mandantenspezifischen Sichten für Betreiber und Partner. Das Muster ist für jede Quelle gleich, die Ereignisse streamt.

Wie stellen Sie sicher, dass die Zahlen stimmen?

Mit dem Fachbereich abgestimmte Definitionen, Tests auf den Daten selbst, Aktualitäts- und Volumenprüfungen und Reprocessing, mit dem wir eine Periode nach einer Korrektur neu berechnen. Korrektheit wird überwacht wie Verfügbarkeit.

Welche Werkzeuge nutzen Sie für Dashboards?

Dashboards im Produkt in React, wenn die Nutzer Ihre Kunden oder Betreiber sind, und Ihr bestehendes BI-Werkzeug, wenn die Nutzer intern sind. Beide lesen aus denselben Kennzahlendefinitionen.

AI-Native entwickelt

Jede Leistung auf dieser Seite wird mit unserem AI-Native-Prozess geliefert: Spezifikationen als Quelle der Wahrheit, Agenten in der Pipeline und ein namentlich verantwortlicher Entwickler, der auf Staging freigibt.

Wie wir mit KI entwickeln →

Sehen, wie das für Ihr Produkt aussieht?

Buchen Sie ein Gespräch — wir gehen Ihre Architektur, Ihre Rahmenbedingungen und die ersten neunzig Tage durch.Technisches Gespräch buchen
CLOUDNONICCLOUDNONICCLOUDNONIC