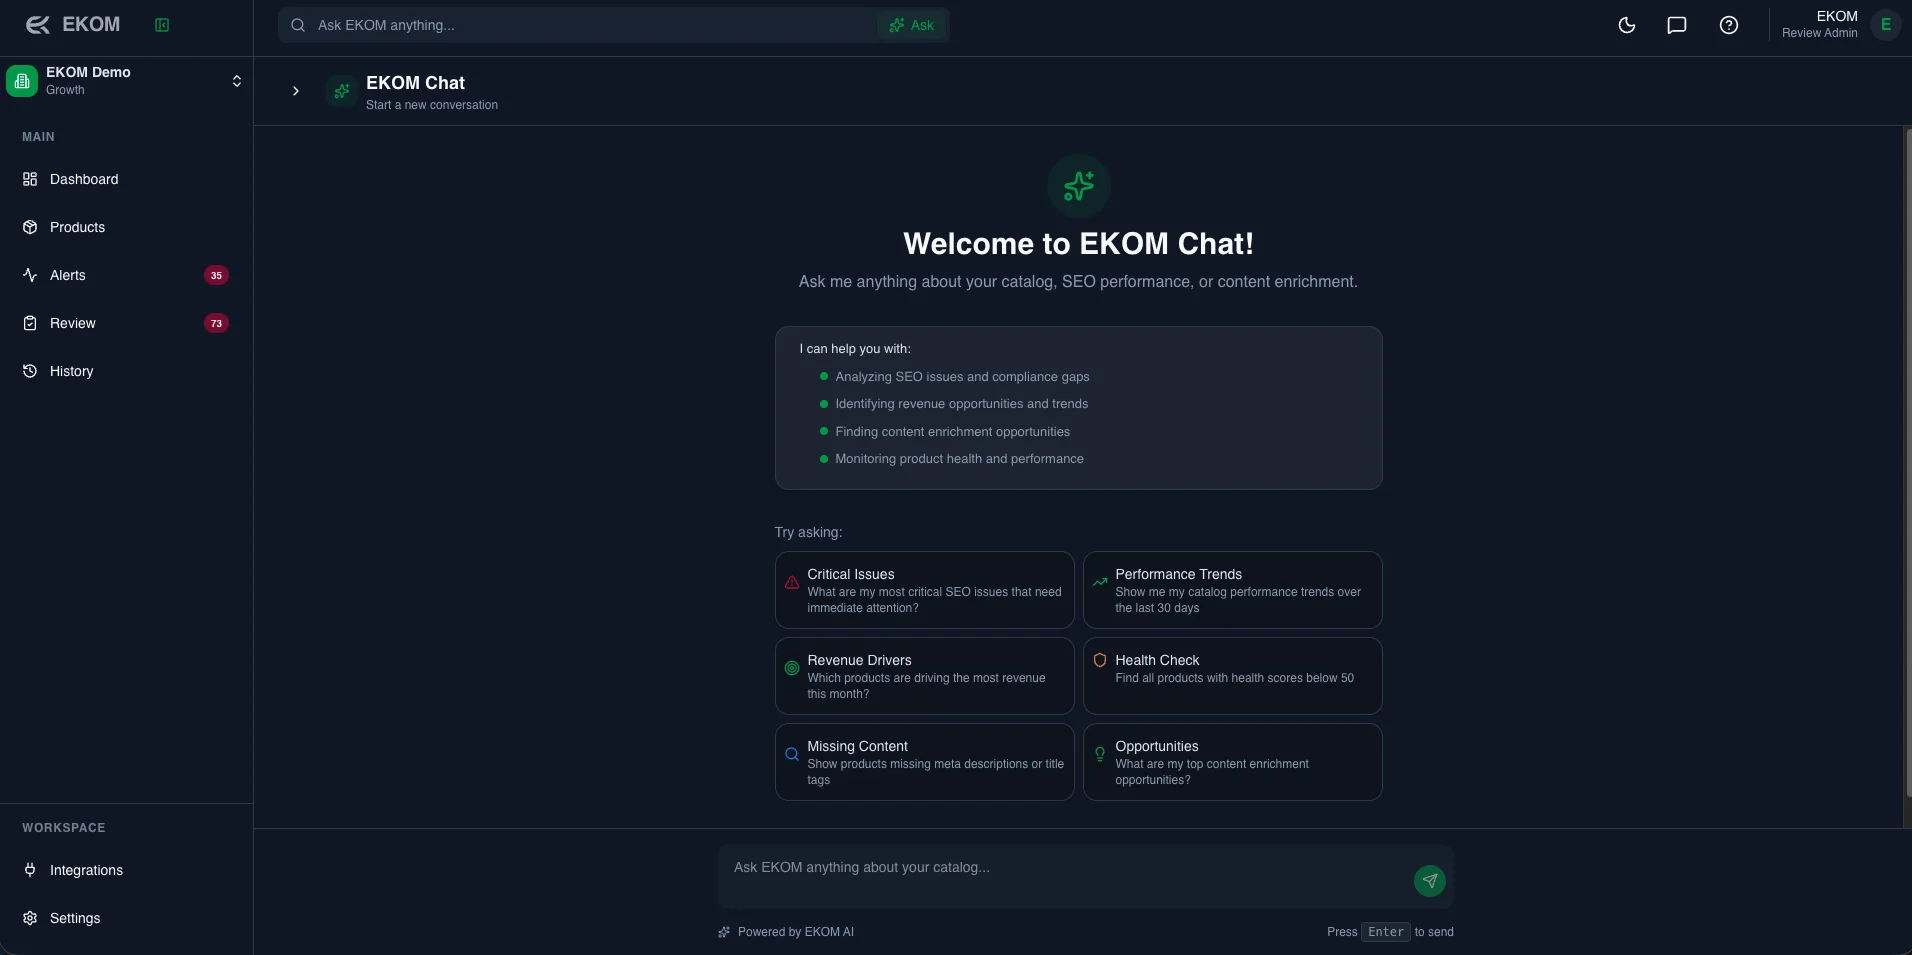
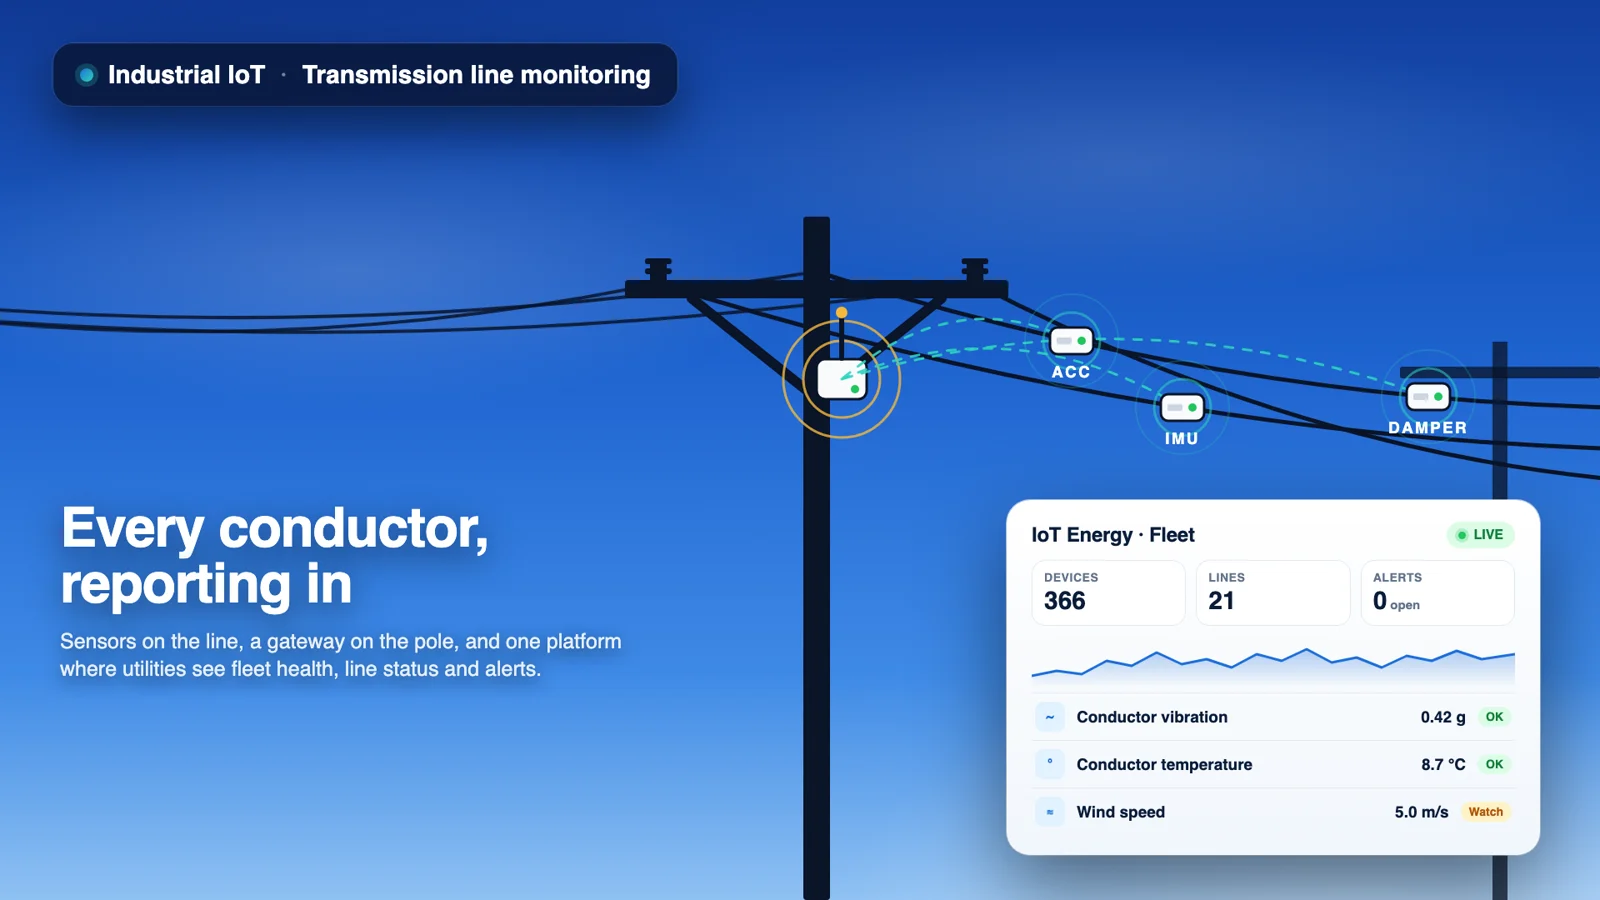
KI für E-Commerce
EKOM AI
- Überwachte Produkte
- 50.000+
- Garantierte Verfügbarkeit
- 99,9%
- Teams vertrauen der Plattform
- 20+
- Support verfügbar
- 24/7
 Python
 React
 AWS
- Python
- React
- AWS
AI-Native Engineering ist die Art, wie Cloudnonic jedes Engagement liefert: ein Senior-Team, das KI-Modelle und Agenten in jedem Schritt des Lebenszyklus einsetzt, vom Ticket bis zum Release, während Entscheidungen, Review und Verantwortung bei namentlich benannten Entwicklern bleiben. Es ist kein Produkt, das wir verkaufen. Es ist der Grund, warum ein Team aus wenigen erfahrenen Menschen Infrastruktur, Backend und Frontend einer Plattform verantworten und trotzdem wöchentlich ausliefern kann.
Fünf Praktiken, jede mit einem menschlichen Prüfpunkt. Zusammen sind sie der Lieferprozess hinter den Plattformen weiter unten auf dieser Seite.
Tickets werden mit dem Kontext geschrieben, den ein Agent braucht, die Umsetzung läuft im Pairing mit einem Coding-Agenten, Pull Requests werden von einem Modell geprüft, bevor ein Mensch sie sieht, und Release Notes und Dokumentation entstehen aus der Änderung selbst. Nichts überspringt die Pipeline.
Jedes Projekt führt eine schriftliche Memory Bank im Repository: Architekturentscheidungen, Domänenregeln, Konventionen und offene Fragen. Agenten und Entwickler lesen dieselben Dokumente, sodass der Kontext nicht im Kopf einer Person lebt und ein neuer Entwickler oder Agent in Tagen produktiv ist.
Agenten übernehmen die repetitiven Teile der Lieferung: Scaffolding aus der Spezifikation, Testgenerierung, Dependency-Updates, Migrationsprüfungen und ein erster Code-Review. Sie laufen in CI mit denselben Berechtigungen und denselben Logs wie jeder andere Job.
Keine Änderung erreicht die Produktion, ohne dass ein namentlich benannter Entwickler sie auf Staging freigibt, mit den generierten Testnachweisen vor sich. Der Agent schlägt vor, der Entwickler entscheidet, und die Freigabe wird protokolliert.
Geheimnisse, personenbezogene Daten und Kundencode verlassen nie die im Vertrag vereinbarten Grenzen: EU-gehostete oder selbst gehostete Modelle, wo erforderlich, kein Training mit Kundendaten, Dependency- und Secret-Scanning bei jedem Lauf und ein Audit-Trail dessen, was jeder Agent getan hat.
Was sich für einen Kunden ändert, ist konkret und zeigt sich in den Zahlen hinter den Fallstudien.
Vom Scoping-Workshop zur ersten funktionierenden Version in Wochen statt Quartalen und ein wöchentlicher Release-Rhythmus ab dem ersten Monat, weil die mechanische Arbeit nicht mehr auf einen freien Entwickler wartet.
Ein Senior-Team aus drei bis fünf Personen leistet die Arbeit, für die früher zehn nötig waren, ohne Junior-Schicht und ohne Projektmanagement-Schicht, die bezahlt werden muss. Sie zahlen für Urteilsvermögen, nicht für Tippen.
Jede Änderung ist mit ihrem Ticket, ihrer Spezifikation, ihren Testnachweisen und ihrer Freigabe verknüpft. Wenn ein Auditor, ein Enterprise-Kunde oder ein neuer CTO fragt, warum etwas so ist, wie es ist, steht die Antwort im Repository.
Weniger Menschen mit jeweils mehr Kontext. Die Entwickler, die das System zuschneiden, sind dieselben, die es betreiben; das hält Schätzungen ehrlich und Vorfälle selten.
Wenn der Berater eines Investors eine Plattform prüft, die wir liefern, existieren die Architecture Decision Records, die Sicherheits- und Datenschutzkonzepte und die Prozessdokumentation, nach denen er fragt, bereits, weil die Liefermethode sie mit jeder Änderung erzeugt hat. So hat GoMedicus seine Due Diligence zur Series A auf Basis von Dokumentation bestanden, die während des Aufbaus entstand und nicht in den Wochen vor der Runde.
Die Leistung Technische Due Diligence →Die so gelieferten Plattformen mit ihren Zahlen. Jede Zahl stammt aus der dahinterliegenden Fallstudie.
PythonReactAWSPythonReactAWS FastAPIReact
 PostgreSQLAWS Lambda
 Terraform
Nein. Es ist die Art, wie wir alle unsere Leistungen erbringen: Produktteams, eingebettete Teams und Projekte mit festem Umfang. Sie zahlen nicht separat dafür, und die Teile, die die Lieferung sicher machen, wie menschliche Freigabe und Audit-Trail, lassen sich nicht abwählen.
KI schreibt eine erste Version von vielem davon, und Entwickler entscheiden, was ausgeliefert wird. Jede Änderung wird von einem Modell und dann von einem namentlich benannten Senior-Entwickler geprüft, getestet und auf Staging von einem Menschen freigegeben. Die Verantwortung für das, was in Produktion ist, liegt bei uns, nicht beim Modell.
Sie bleiben innerhalb der Grenzen, die wir im Vertrag vereinbaren. Wir nutzen Anbieter mit EU-Datenresidenz oder selbst gehostete Modelle, wenn die Datenklassifizierung es verlangt, keine Kundendaten werden zum Training verwendet, und Memory Bank, Agenten-Logs und Audit-Trail liegen in Ihren Repositories.
Ja, und eingebettete Engagements beinhalten das oft: Wir richten Memory Bank, Pipeline-Agenten und Review-Ablauf in Ihren Repositories ein, arbeiten darin mit Ihren Entwicklern und übergeben alles dokumentiert.
An denselben Maßen wie bei jeder Lieferung: Durchlaufzeit vom Ticket bis zur Produktion, Release-Frequenz, Fehlerrate bei Änderungen und Wiederherstellungszeit. Die Fallstudien auf dieser Seite zeigen die Zahlen für so betriebene Plattformen.