Datos y analítica

Datos y analítica integrados en el producto

Cloudnonic construye los pipelines de datos, la analítica y los informes que hacen útil un producto para las personas que lo operan: dispositivos de campo que transmiten a una plataforma de monitorización, catálogos de productos que alimentan un motor de optimización, paneles operativos que un equipo abre cada mañana. Trabajamos en Python y PostgreSQL sobre AWS, dentro del producto y no al lado, con la misma responsabilidad sobre la corrección y la operación que en el resto de la plataforma.

50.000+
Productos monitorizados
EKOM AI
99,9%
Disponibilidad garantizada
EKOM AI
20+
Equipos confían en la plataforma
EKOM AI

Qué incluye

Modelado de datos e ingesta

Esquemas para los eventos y entidades que importan, e ingesta desde dispositivos, APIs y archivos que es idempotente, validada y monitorizada.

Pipelines y procesamiento

Procesamiento por lotes y en streaming en Python sobre AWS, con linaje y reprocesado, para que un error en una transformación se corrija y se reejecute en lugar de parchearse.

Analítica y paneles

Métricas definidas una sola vez y acordadas con negocio, servidas en paneles integrados en el producto o en las herramientas que tu equipo ya usa.

Alertas y vistas operativas

Alertas por umbral y por anomalía para los operadores, con el contexto que necesitan para actuar, no solo un número que cruzó una línea.

Calidad de datos y operación

Pruebas sobre los propios datos, comprobaciones de frescura, monitorización de coste y un ingeniero con nombre que se hace cargo del pipeline en producción.

Qué sale mal, y qué decidimos en su lugar

  1. Paneles antes que definiciones

    Los gráficos se construyen con lo que haya en la base de datos, y dos equipos leen números distintos para la misma métrica.

    Lo que cuesta

    Reuniones dedicadas a discutir los datos en lugar de decidir, y un informe para el consejo en el que nadie confía.

    Cómo decidimos

    Cada métrica se define una sola vez, con su responsable y su fuente, antes de dibujar un gráfico.

  2. Pipelines sin reprocesado

    Un error de transformación se descubre semanas después y no hay forma de recalcular el histórico, así que el error se documenta en lugar de corregirse.

    Lo que cuesta

    Informes permanentemente erróneos y correcciones manuales en cada periodo.

    Cómo decidimos

    Se conservan los datos en bruto, las transformaciones están versionadas y son idempotentes, y reprocesar un periodo es una operación rutinaria.

  3. La analítica como proyecto aparte

    Un proveedor de BI construye informes al lado del producto, con su propia copia de los datos, y nadie se hace cargo del hueco entre ambos.

    Lo que cuesta

    Números desactualizados, costes duplicados y un producto que no puede mostrar a sus propios usuarios lo que está pasando.

    Cómo decidimos

    La analítica la integra en el producto el equipo que se hace cargo del modelo de datos, y las herramientas de informes leen de las mismas definiciones.

Cómo trabajamos contigo

Cómo trabajamos contigo

El trabajo de datos suele formar parte de un proyecto de plataforma más amplio, porque el valor está en el producto que los datos alimentan. También puede empezar como alcance fijo: un pipeline y un conjunto de paneles con una definición acordada de correcto, que después crece con el producto.

Tu equipo de producto · Lo que evita: Un prototipo que nunca llega a ser plataforma y una contratación de CTO antes de que el producto la merezca.

Los dos modelos de colaboración →

Stack que usamos

Elegido por proyecto. Escogemos lo que tu equipo pueda operar después de nosotros, no lo que está de moda.

  • Python
  • PostgreSQL
  • FastAPI
  • AWS Lambda
  • React
  • React
  • AWS Lambda
  • FastAPI
  • PostgreSQL
  • Python

Pruebas

Casos de estudio en este ámbito. Cada cifra sale del caso que la respalda.

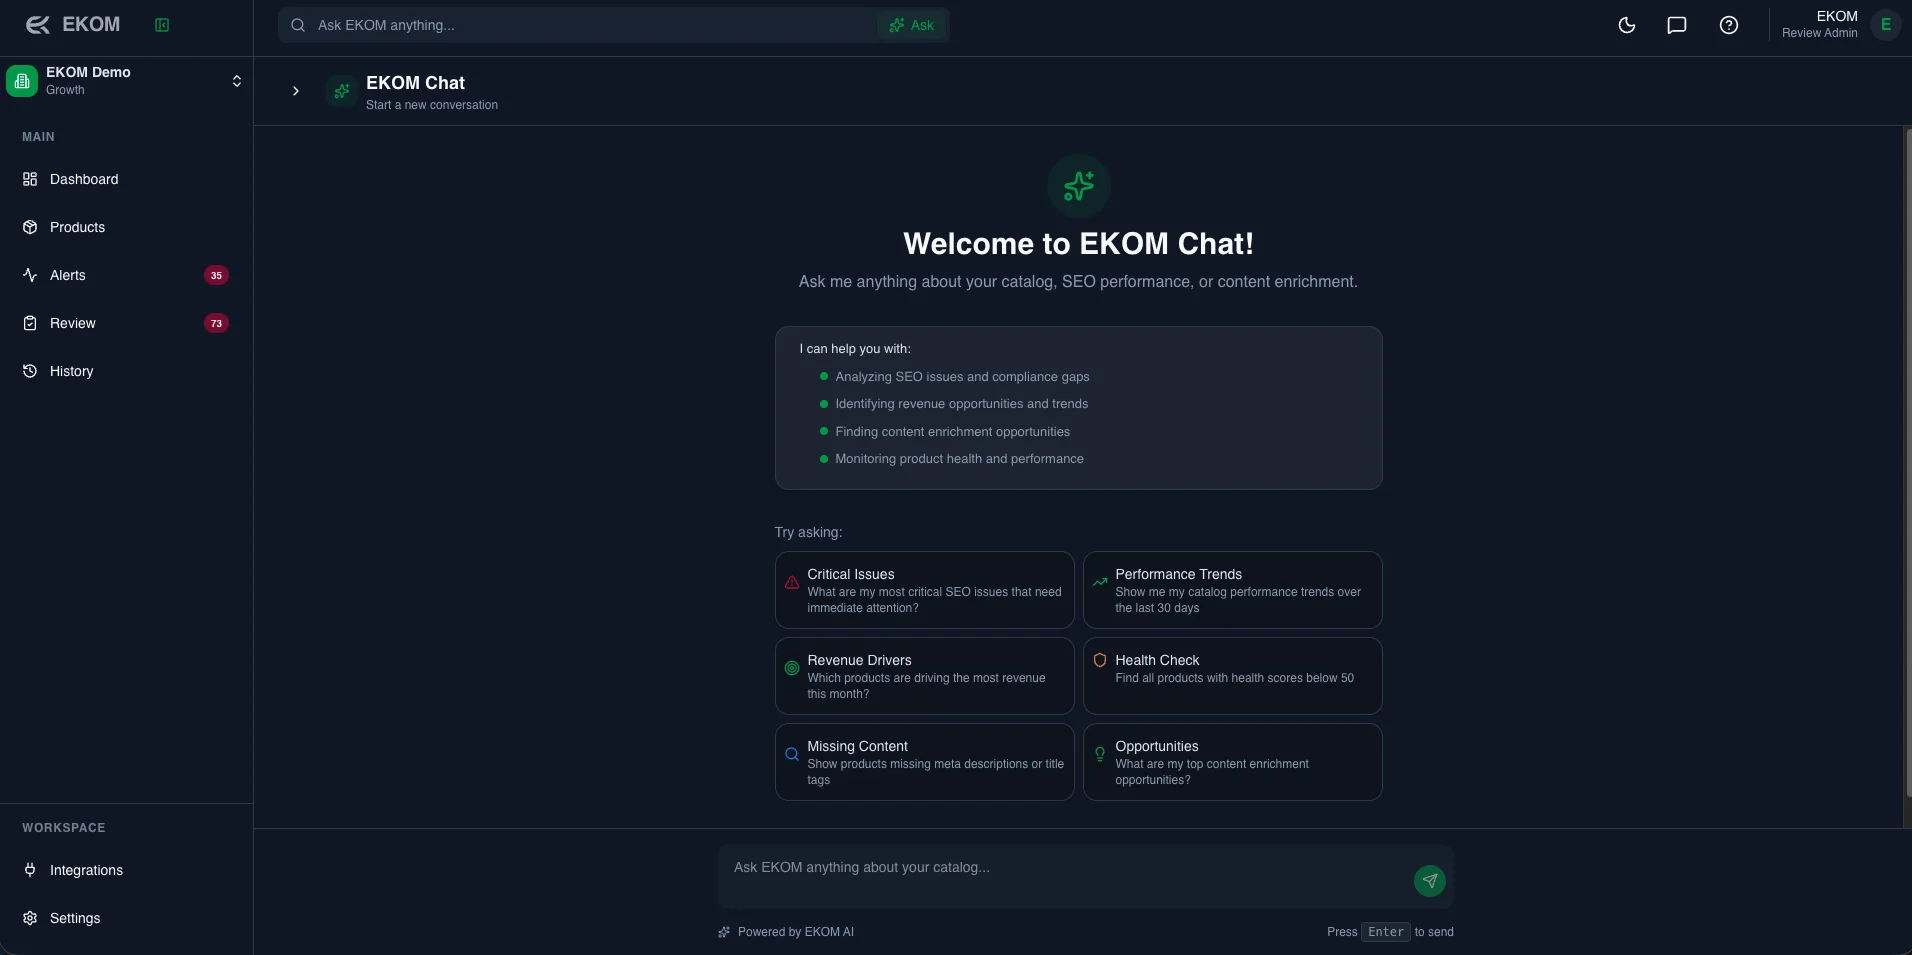
IA para e-commerce

EKOM AI

Productos monitorizados
50.000+
Disponibilidad garantizada
99,9%
Equipos confían en la plataforma
20+
Soporte disponible
24/7
  • Python
  • React
  • AWS
  • Python
  • React
  • AWS
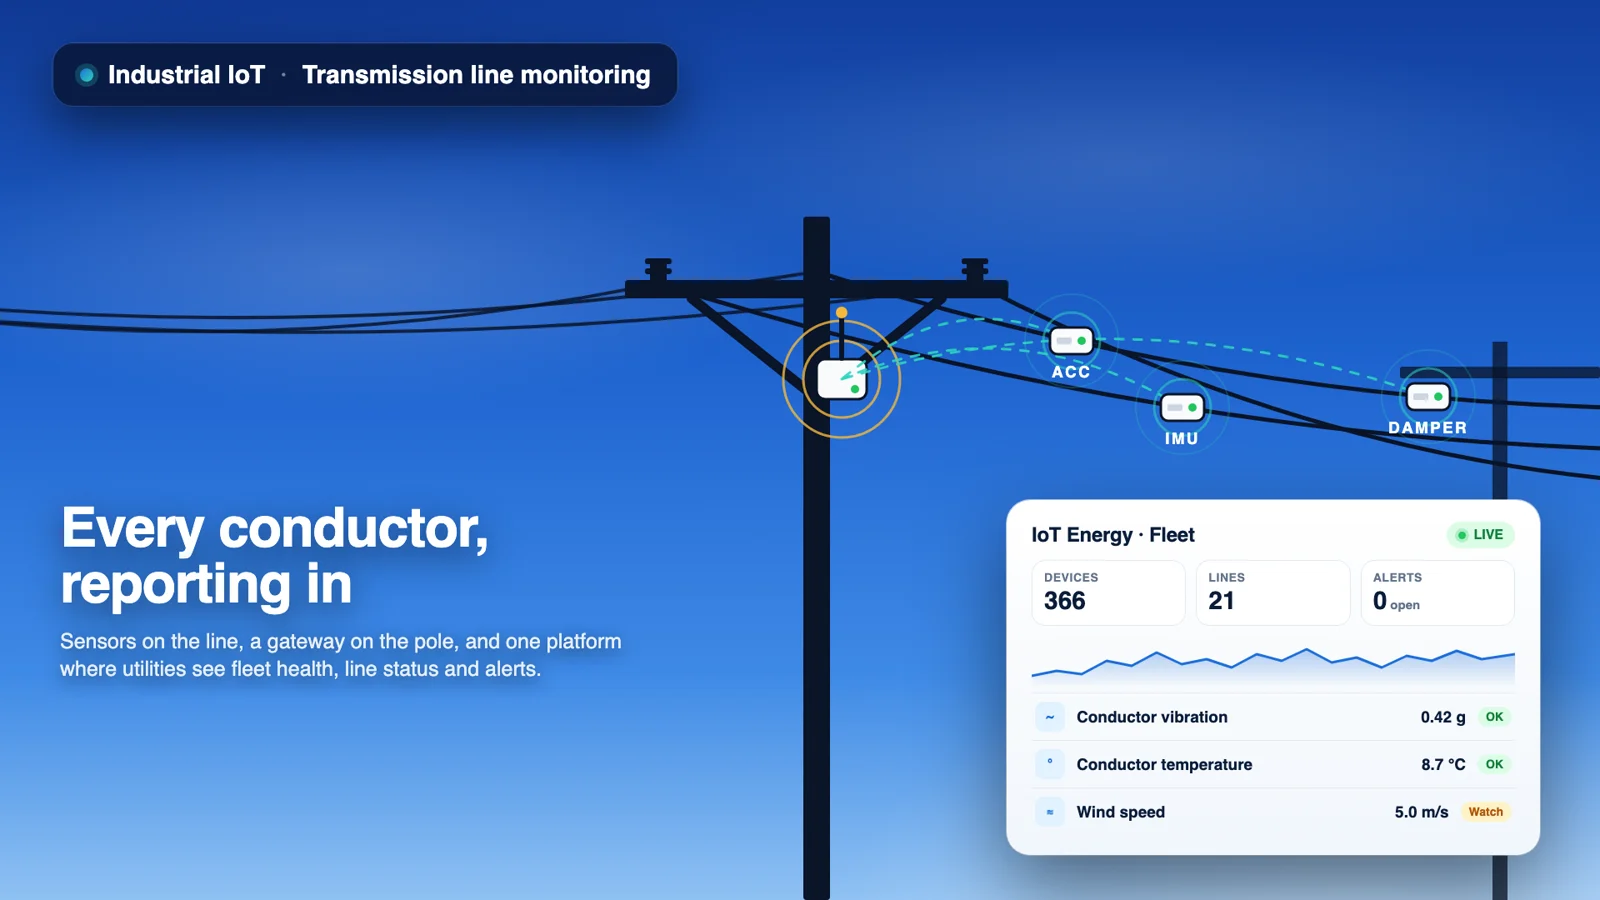
IoT industrial — plataforma de monitoreo de red

IoT Energy

Dispositivos de campo registrados en la plataforma
366+
Líneas de transmisión monitoreadas
21+
Operadores y socios con su propio inquilino
13+
Tipos de sensor con su propia cadena de procesamiento
5+
  • FastAPI
  • React
  • PostgreSQL
  • AWS Lambda
  • Terraform

Preguntas frecuentes

¿Construís data warehouses?

Cuando el producto lo necesita. Para la mayoría de las plataformas que operamos, PostgreSQL con esquemas bien diseñados y procesamiento en Python sobre AWS cubre la carga analítica. Introducimos un warehouse o una capa de streaming cuando el volumen o la latencia lo exigen, y decimos qué números lo justifican.

¿Podéis conectar dispositivos de campo y equipos industriales?

Sí. Hemos construido la ingesta de cientos de dispositivos de campo de varios tipos en una única plataforma de monitorización, con vistas por inquilino para operadores y socios. El patrón es el mismo para cualquier fuente que transmita eventos.

¿Cómo os aseguráis de que los números son correctos?

Definiciones acordadas con negocio, pruebas sobre los propios datos, comprobaciones de frescura y volumen, y un reprocesado que permite recalcular un periodo tras una corrección. La corrección se monitoriza como la disponibilidad.

¿Qué herramientas usáis para los paneles?

Paneles integrados en el producto en React cuando los usuarios son tus clientes u operadores, y tu herramienta de BI actual cuando los usuarios son internos. Ambos leen de las mismas definiciones de métricas.

Construido a la manera AI-Native

Todos los servicios de esta página se entregan con nuestro proceso AI-Native: especificaciones como fuente de verdad, agentes en el pipeline y un ingeniero con nombre que aprueba en staging.

Cómo construimos con IA →

¿Quieres ver cómo funcionaría para tu producto?

Agenda una llamada y repasamos tu arquitectura, tus limitaciones y cómo serían los primeros noventa días.Agendar consulta técnica
CLOUDNONICCLOUDNONICCLOUDNONIC